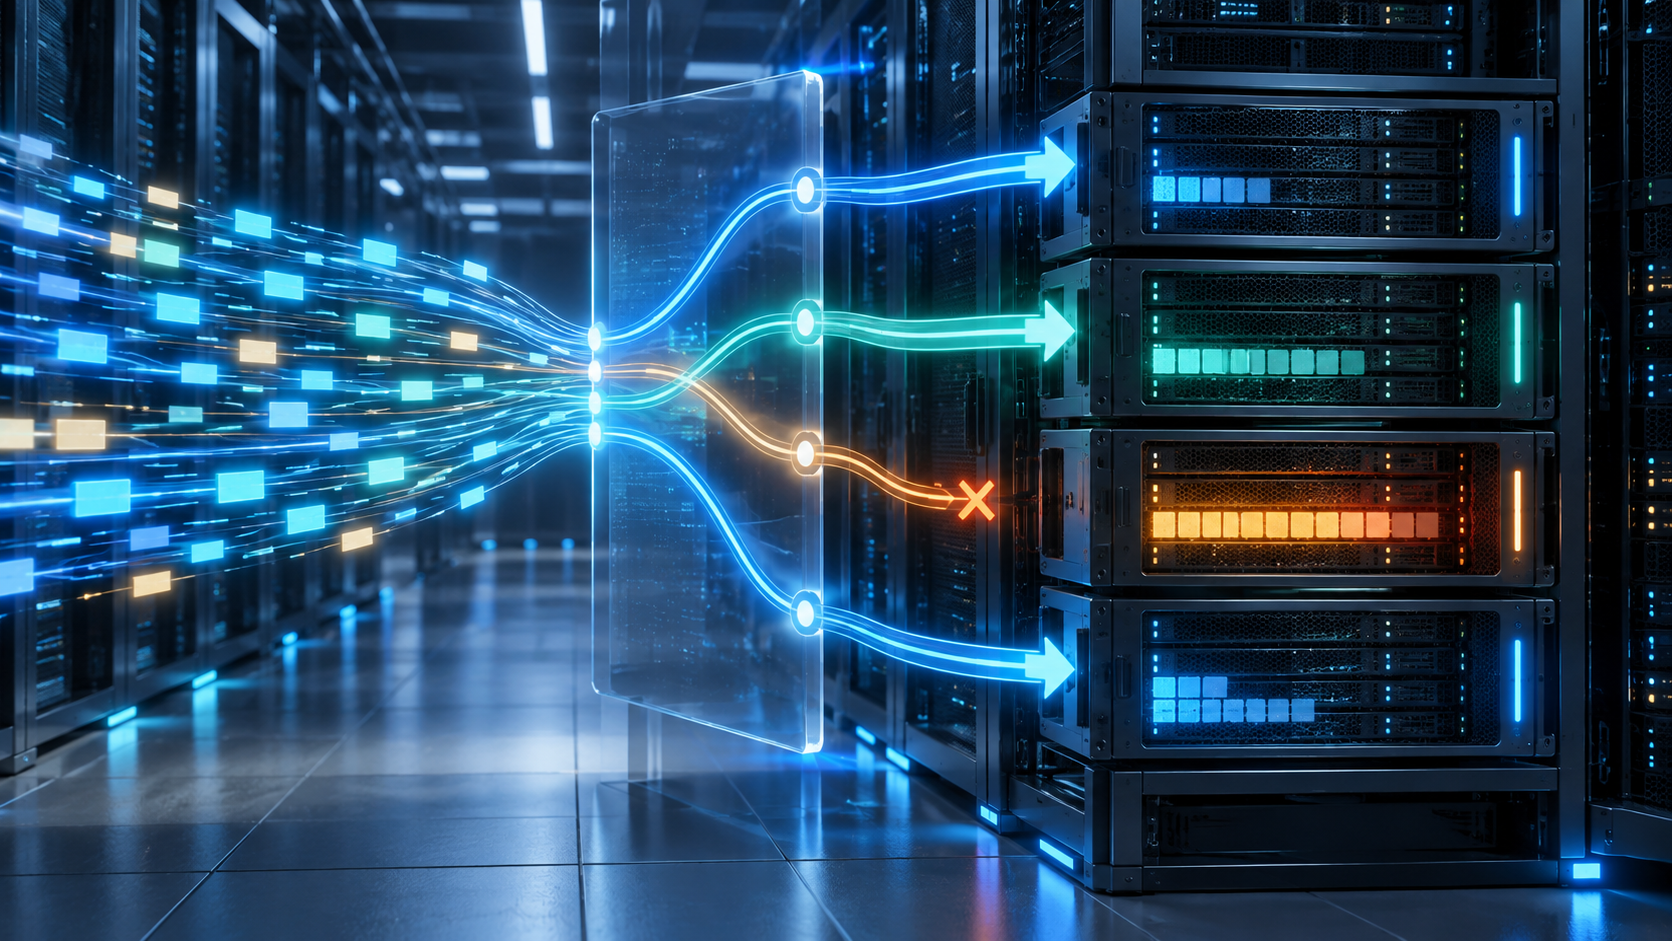
SageMaker HyperPod Inference Gateway distribuye cada consulta según la carga real de las GPU. Las mejoras son cifras de AWS y dependen del tipo de tráfico.
Un problema costoso escondido detrás de cada respuesta
Amazon Web Services presentó el 18 de septiembre de 2026 una pieza de infraestructura pensada para un problema que el usuario final casi nunca ve: un clúster puede tener GPU libres y, aun así, acumular consultas detrás de un servidor saturado. El nuevo Amazon SageMaker HyperPod Inference Gateway intenta evitar esa contradicción al decidir dónde enviar cada solicitud según lo que está ocurriendo dentro de los equipos.
El anuncio no es un modelo nuevo ni una mejora de razonamiento. Es un sistema de distribución para la etapa de inferencia, es decir, cuando un modelo ya entrenado recibe una consulta y produce una respuesta. En servicios con miles de pedidos simultáneos, una mala decisión de routing puede aumentar la latencia y empujar a la empresa a comprar capacidad que después permanece ociosa.
Los balanceadores tradicionales de Kubernetes suelen repartir tráfico por turnos o por cantidad de conexiones. Esa lógica funciona para muchas aplicaciones web, pero no observa condiciones específicas de los modelos grandes: cuánto espacio queda en la memoria de claves y valores, cuántas respuestas largas procesa un servidor, qué adaptador LoRA ya está cargado o si un prefijo frecuente está guardado en caché.
AWS sostiene que su gateway usa esas señales para elegir el destino más conveniente. En el ejemplo destacado por la compañía, el tiempo hasta el primer token bajó de 4,4 segundos a menos de 800 milisegundos, una reducción aproximada de 82%. Es una cifra atractiva, pero corresponde a pruebas del proveedor y no debe leerse como garantía para cualquier instalación.
Cómo decide a qué GPU enviar cada consulta
El sistema se instala como un complemento administrado de Amazon EKS sobre la infraestructura de SageMaker HyperPod. La primera capa recibe la solicitud, identifica el modelo solicitado y la dirige al grupo adecuado. Dentro de ese grupo, un selector evalúa métricas en tiempo real antes de elegir el servidor.
Según la explicación técnica de AWS, la decisión puede considerar cinco señales principales:
- ocupación de la caché KV, para evitar servidores con la memoria casi llena;
- profundidad de la cola, para no agregar trabajo detrás de muchas solicitudes pendientes;
- presencia del adaptador LoRA pedido, evitando cargarlo nuevamente cuando ya reside en una GPU;
- probabilidad de reutilizar un prefijo guardado en caché;
- cantidad de solicitudes que el servidor procesa en ese momento.
Los administradores pueden asignar distintos pesos a estas señales. Una aplicación conversacional puede priorizar una respuesta inicial rápida, mientras un proceso por lotes puede favorecer el rendimiento total. El gateway expone un endpoint compatible con el esquema de la API de OpenAI, pero esa compatibilidad describe el formato de las solicitudes; no significa que el producto pertenezca a OpenAI ni que requiera sus modelos.
AWS afirma que funciona con servidores como vLLM, SGLang y TGI. También utiliza componentes de Kubernetes y la Gateway API Inference Extension, una iniciativa abierta para adaptar el routing a cargas de inteligencia artificial.
Los benchmarks muestran ventajas, pero también un límite importante
La empresa probó cuatro modelos de entre 8.000 millones y 235.000 millones de parámetros sobre instancias con GPU H100 y A10G. Comparó el gateway con un balanceo round-robin usando las mismas réplicas. En escenarios con generaciones distintas de GPU o tráfico en ráfagas, la tabla publicada muestra reducciones de hasta 98% en percentiles altos del tiempo hasta el primer token y mejoras de rendimiento de hasta 50%.
Esas cifras no son una evaluación independiente. AWS diseñó el producto, ejecutó las pruebas y publicó los resultados. La metodología descrita permite entender las condiciones generales, pero no sustituye una reproducción externa ni prueba cuánto se ahorrará en una aplicación concreta.
El propio anuncio contiene un dato que modera la promesa: cuando la flota es uniforme y el tráfico permanece estable, el desempeño fue comparable al round-robin. Eso tiene sentido. Si todos los servidores tienen capacidad parecida, no hay una gran desigualdad que corregir. El beneficio aparece sobre todo cuando las GPU, los modelos o las solicitudes son heterogéneos.
Para una empresa, por tanto, la pregunta correcta no es “¿bajará mi latencia 82%?”, sino “¿mi tráfico presenta los desequilibrios que este router sabe detectar?”. Antes de adoptar el sistema conviene medir distribución de colas, ocupación de caché, tiempo hasta el primer token, rendimiento por GPU y porcentaje de capacidad ociosa.
Qué está disponible y qué sigue pendiente
La capa por clúster, denominada Tier 1, está disponible en las regiones donde AWS ofrece el complemento de inferencia de HyperPod. La empresa no publicó en el anuncio una lista completa de precios nuevos atribuibles al gateway ni confirmó disponibilidad específica para una región sudamericana.
La segunda capa, Global Inference Router, todavía figura como próxima. Está diseñada para coordinar varios clústeres y regiones, aplicar límites globales, realizar failover y considerar costos al mover tráfico. Es importante separar esa hoja de ruta del producto disponible: una organización no debería diseñar hoy una recuperación multirregional suponiendo que todas esas funciones ya están listas.
AWS también menciona futuras divisiones de tráfico para versiones canary y bandas de prioridad. Son planes, no capacidades confirmadas para producción al momento del anuncio.
Por qué importa para equipos de Paraguay y América Latina
El costo de la inferencia es una barrera para empresas regionales que quieren pasar de un prototipo a un servicio estable. Aunque muchas organizaciones no administran grandes clústeres propios, la lógica del anuncio es relevante: mejorar el software que asigna trabajo puede producir más capacidad sin comprar inmediatamente más hardware.
Para un equipo paraguayo que use AWS, el primer paso sería confirmar si HyperPod y el complemento están disponibles en la región elegida, revisar transferencia de datos y estimar latencia desde sus usuarios. Una mejora dentro del clúster puede quedar opacada por una ruta de red larga, una base de datos lenta o una aplicación que envía prompts innecesariamente extensos.
También hay una decisión de dependencia tecnológica. El gateway se presenta como Kubernetes-native y compatible con herramientas conocidas, pero sigue integrado a EKS y SageMaker HyperPod. Antes de adoptarlo, conviene documentar qué componentes podrían migrarse, cómo se exportan métricas y qué ocurriría con el costo si cambia el volumen.
Un piloto serio debería comparar tres configuraciones con la misma carga: el balanceo actual, el gateway con valores predeterminados y una versión ajustada. Medí no solamente latencia media, sino P95 y P99, tokens por segundo, errores 429, consumo de GPU y costo por millón de tokens servidos. Si el sistema reduce la espera pero aumenta fallas o complejidad operativa, el balance puede no ser favorable.
La carrera de IA también se libra en el tráfico interno
La industria suele concentrarse en modelos y chips, pero una parte creciente de la competencia está en cómo se usan esos chips. Cuando una GPU de alto costo queda ociosa mientras otra acumula cola, el problema no se resuelve con más parámetros: se resuelve con mejor observabilidad y scheduling.
HyperPod Inference Gateway muestra ese cambio de foco. AWS intenta convertir métricas internas del modelo en decisiones de infraestructura y promete mejoras grandes cuando el tráfico es irregular. La propuesta es técnicamente plausible y el contraste con una flota uniforme ayuda a delimitarla, pero las cifras siguen siendo del proveedor.
La prueba decisiva llegará cuando clientes publiquen resultados reproducibles, costos completos y comportamiento en fallas reales. Hasta entonces, el 82% sirve para abrir una conversación, no para cerrar un presupuesto.
Fuentes
- AWS: Introducing Amazon SageMaker HyperPod Inference Gateway, 18 de septiembre de 2026.
- Kubernetes SIG Network: Gateway API Inference Extension, documentación vigente al 19 de septiembre de 2026.