<!-- Opciones de titular: 1. Google presenta EmbeddingGemma 2, un modelo multimodal de 740 millones de parámetros para ejecutar en dispositivos 2. EmbeddingGemma 2 lleva búsquedas de texto, imagen y audio a equipos con recursos limitados 3. Google abre EmbeddingGemma 2 para crear búsquedas multimodales locales sin generar contenido Titular elegido: opción 2, porque destaca la función y el entorno de uso sin confundir embeddings con generación. -->
# EmbeddingGemma 2 lleva búsquedas de texto, imagen y audio a equipos con recursos limitados
El modelo abierto de Google tiene 740 millones de parámetros y convierte distintos tipos de contenido en vectores comparables. No genera texto ni imágenes: sirve para recuperar, clasificar y relacionar información.
Un modelo para encontrar, no para redactar
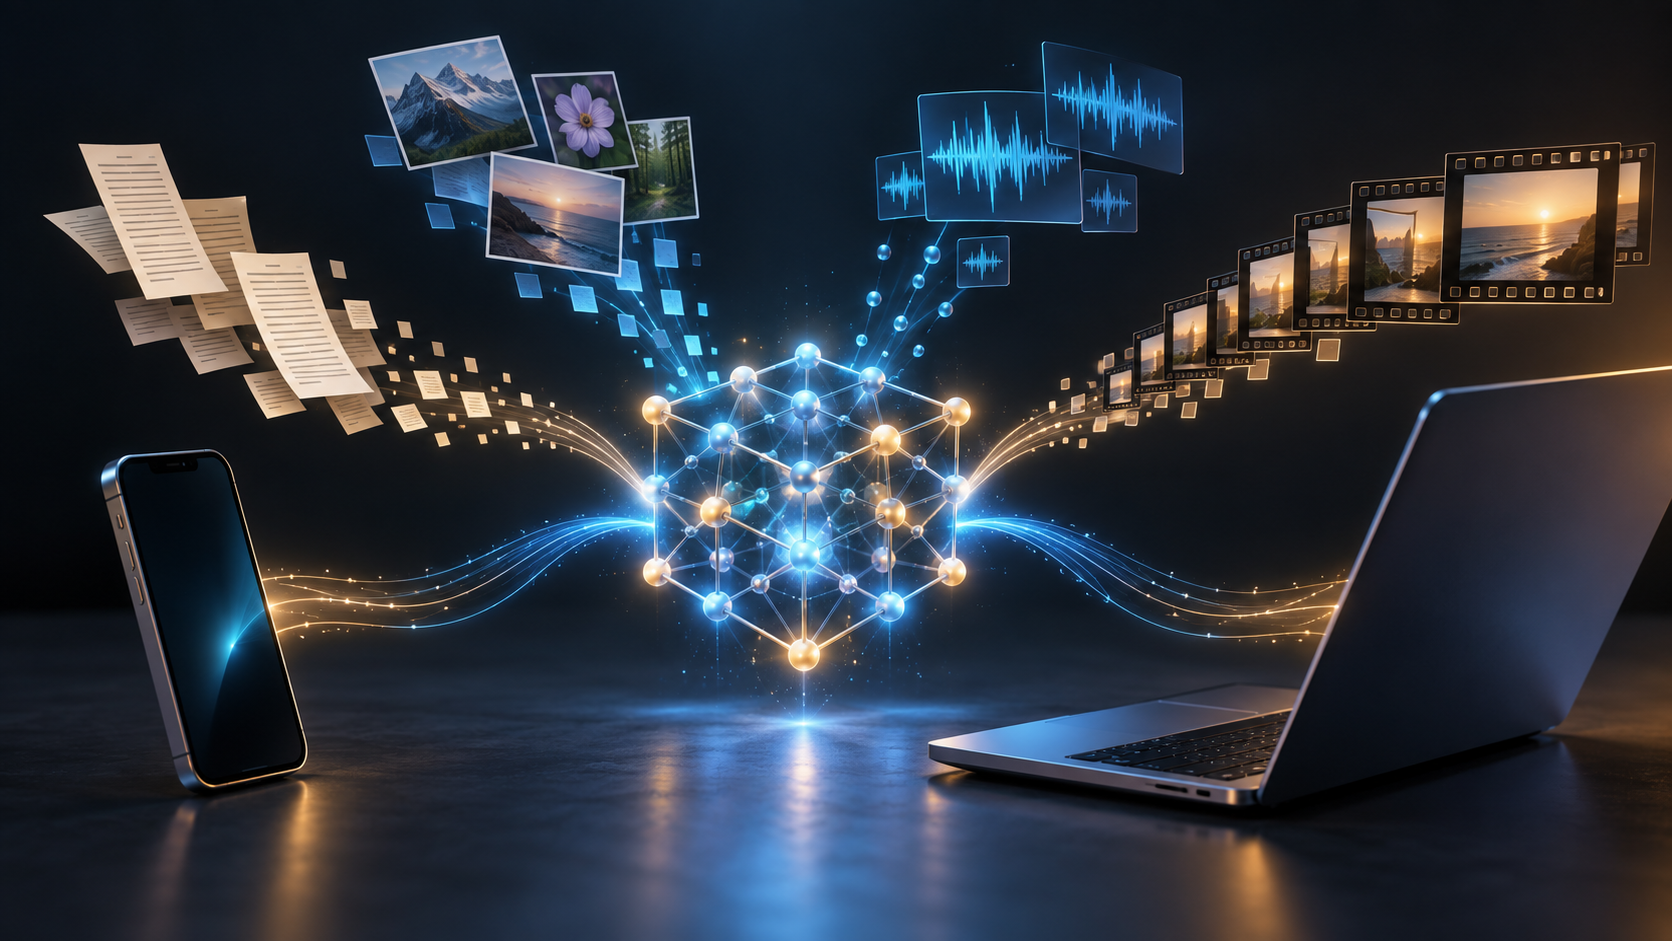
Google presentó el 6 de octubre EmbeddingGemma 2, un modelo de 740 millones de parámetros capaz de representar texto, código, imágenes, fotogramas de video y audio en un mismo espacio numérico. Está diseñado para ejecutar tareas de recuperación y comparación en dispositivos con recursos limitados, incluidos teléfonos.
Un *embedding* es una lista de números que resume características de un contenido. Si dos elementos tienen significados o rasgos relacionados, sus vectores deberían quedar cerca dentro de ese espacio. Una aplicación puede usar esa distancia para buscar una foto a partir de una frase, recuperar un pasaje relevante, agrupar archivos o encontrar audio relacionado.
Esa función es diferente de la IA generativa. EmbeddingGemma 2 no redacta respuestas, no crea imágenes y no mantiene una conversación. Produce representaciones de 768 dimensiones que después utiliza otro componente de la aplicación. Confundir ambos tipos de modelo llevaría a esperar capacidades que el lanzamiento no promete.
Qué incluye EmbeddingGemma 2
El modelo forma parte de la familia Gemma 4 y distribuye sus 740 millones de parámetros en tres componentes, de acuerdo con Google: 270 millones para texto, 170 millones para visión y 300 millones para audio. Admite una ventana de contexto de hasta 8.192 tokens para entradas textuales.
Los pesos se publican bajo licencia Apache 2.0 y están disponibles en Hugging Face y Kaggle. Google también anunció integración con MediaPipe y LiteRT para ejecución en el borde, mientras que su llegada a Model Garden figura como próxima. “En el borde” significa procesar en el dispositivo o cerca del lugar donde se generan los datos, en vez de enviar cada entrada a un servidor remoto.
La combinación multimodal permite consultar una colección con un tipo de entrada y recuperar otro. Por ejemplo, una descripción puede localizar imágenes; una imagen puede relacionarse con fragmentos de texto; y un clip de audio puede compararse con otros contenidos. El resultado concreto depende de cómo el desarrollador indexe los datos, mida similitud y presente los candidatos.
Por qué importa ejecutar embeddings localmente
Los embeddings suelen alimentar sistemas de búsqueda semántica y generación aumentada por recuperación, conocida como RAG. Antes de pedir a un modelo generativo que responda, una aplicación busca documentos relevantes y los incorpora como contexto. Si esa primera búsqueda falla, la respuesta puede ignorar la información necesaria aunque el generador sea potente.
Ejecutar el modelo localmente puede reducir latencia y evitar el envío constante de archivos a la nube. Eso resulta útil en aplicaciones con conectividad inestable, colecciones privadas o necesidad de respuesta inmediata. También puede disminuir el costo variable por consulta cuando el dispositivo ya tiene recursos suficientes.
Pero “local” no equivale automáticamente a “privado”. La aplicación todavía puede transmitir telemetría, consultas o resultados; el índice vectorial puede contener información sensible; y otros componentes pueden depender de servicios remotos. Para evaluar privacidad necesitás revisar el flujo completo, no solo el lugar donde corre el modelo de embeddings.
Rendimiento: afirmaciones que necesitan pruebas propias
Google publica resultados de benchmarks y cifras de memoria para respaldar el lanzamiento. Entre ellas aparecen mediciones de 191 MB y 567 MB en un Pixel 11 Pro bajo configuraciones diferentes. Esos números son afirmaciones del proveedor obtenidas en su entorno de prueba; no garantizan el mismo consumo en otro teléfono, sistema operativo o aplicación.
La memoria total de una app incluye más que los pesos: runtime, índice, buffers, decodificación de imágenes o audio e interfaz. El tiempo de respuesta también varía según longitud de la entrada, cuantización, acelerador disponible, temperatura del dispositivo y ejecución simultánea de otras tareas.
Los benchmarks de calidad tienen límites similares. Una posición alta en un conjunto de evaluación no demuestra que el modelo encuentre correctamente facturas paraguayas, documentos jurídicos en español o fotografías de un catálogo específico. Cada organización debe construir pruebas con consultas reales, resultados relevantes y casos difíciles de su dominio.
Cómo podría usarse en productos concretos
Un desarrollador puede emplearlo para una galería que encuentre fotos mediante descripciones naturales, una aplicación que busque notas por significado o una herramienta que relacione fragmentos de audio con documentos. También podría servir para clasificar contenido antes de que otro modelo lo procese.
El flujo básico tiene cuatro etapas. Primero, definí qué modalidades vas a indexar. Segundo, generá y almacená un vector por elemento. Tercero, convertí la consulta al mismo espacio. Cuarto, recuperá los vecinos más cercanos y aplicá filtros de negocio, permisos y relevancia.
La calidad no debe medirse solo con una demostración llamativa. Prepará un conjunto de consultas con respuestas esperadas, incluí términos locales y errores frecuentes, y registrá precisión, latencia, memoria y consumo de batería. Compará también con una búsqueda textual convencional: en algunas colecciones pequeñas o muy estructuradas, una solución más simple puede ser suficiente.
Qué significa para Paraguay y América Latina
La ejecución local tiene interés en una región donde la conectividad, el costo de nube y la capacidad de los dispositivos varían mucho. Una app educativa o productiva podría mantener funciones de búsqueda aun con conexión limitada. El soporte multimodal también abre usos para colecciones donde conviven texto, imágenes y audio.
Sin embargo, el tamaño de 740 millones de parámetros no garantiza que funcione bien en cualquier teléfono económico. Equipos locales deberían medir memoria, velocidad y batería en los dispositivos realmente usados por su público. También corresponde probar español paraguayo, guaraní y jopara; el anuncio global no aporta resultados específicos para esas variedades.
La licencia Apache 2.0 facilita experimentar y adaptar una solución, pero no elimina obligaciones sobre datos personales, derechos de autor o seguridad. Si indexás documentos internos, controlá quién puede consultar cada vector y evitá que la búsqueda revele fragmentos a usuarios sin permiso.
Qué conviene observar ahora
La integración prometida con Model Garden ampliaría las opciones de despliegue dentro del ecosistema de Google. También habrá que revisar herramientas, conversiones y ejemplos que reduzcan la distancia entre descargar los pesos y entregar una aplicación estable.
La prueba decisiva será el rendimiento fuera de los benchmarks del proveedor. Desarrolladores independientes podrán comparar calidad, memoria y latencia en distintos dispositivos, idiomas y tipos de contenido. Hasta entonces, EmbeddingGemma 2 ofrece una base abierta y compacta para búsqueda multimodal, no una garantía de precisión universal ni un sustituto de los modelos generativos.
Fuentes
- Google: anuncio de EmbeddingGemma 2, 6 de octubre de 2026.
- Google Developers Blog: EmbeddingGemma 2 en Google AI Edge, 6 de octubre de 2026.
- Google Developers Blog: guía para desarrolladores, 6 de octubre de 2026.
- Google AI for Developers: ficha del modelo EmbeddingGemma 2, consultada el 7 de octubre de 2026.