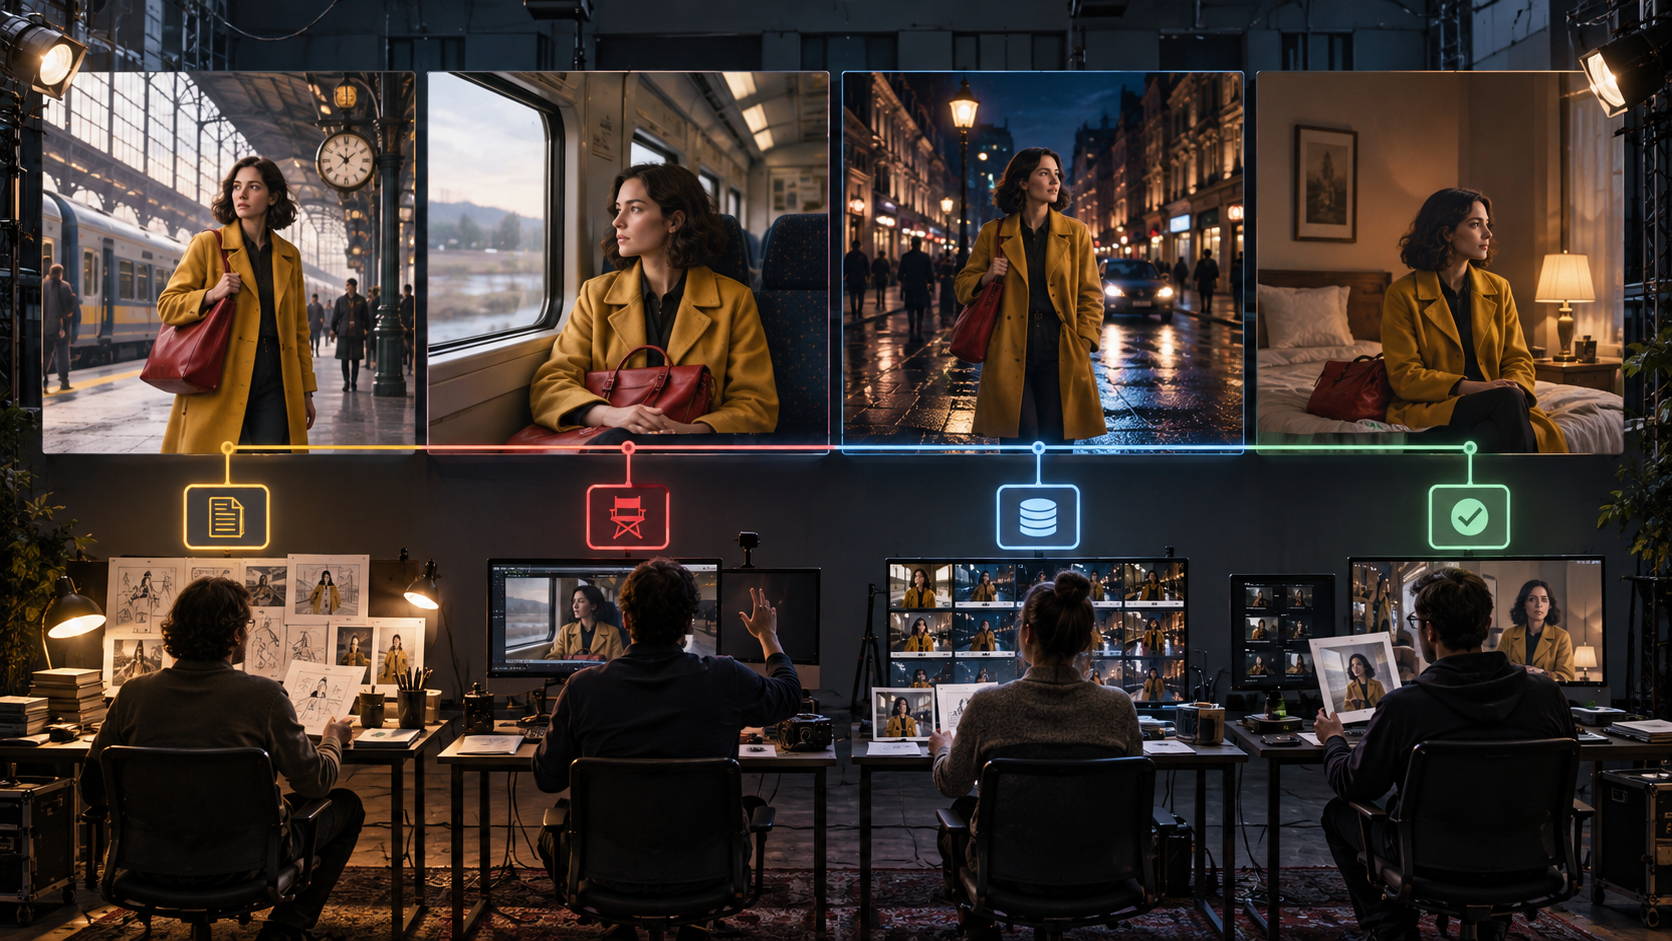
Google Research reunió cuatro trabajos que intentan resolver una limitación persistente del video generativo: producir algo más largo que un clip atractivo sin perder personajes, objetos, escenarios o lógica narrativa en el camino. Los sistemas usan varios agentes de inteligencia artificial para dividir tareas de planificación, dirección, generación, revisión y corrección, apoyándose en modelos como Gemini y Veo. La publicación del 24 de septiembre de 2026 sintetiza investigaciones presentadas entre marzo y mayo; no anuncia una herramienta disponible para usuarios ni una nueva API.
Del prompt único a un equipo de agentes
Generar un clip breve permite concentrar el problema en pocos segundos. Una historia extensa exige conservar la apariencia de un personaje, recordar dónde está cada objeto, conectar acciones y mantener una progresión comprensible entre tomas. Un error pequeño puede acumularse: una prenda cambia, una puerta aparece en otro lugar o una acción posterior contradice lo ocurrido antes.
La propuesta descrita en “Automating coherent long-form video generation” de Google Research consiste en distribuir el trabajo. En vez de pedir a un único modelo que produzca toda la pieza desde una sola instrucción, distintos agentes elaboran el guion visual, convierten escenas en planos, mantienen fichas de personajes, revisan continuidad o evalúan el resultado. Después pueden retroalimentar el proceso y volver a generar partes defectuosas.
“Agente” no significa aquí una persona digital autónoma que dirige una producción real. Es un componente de software que recibe un rol, consulta información, llama modelos y entrega una salida a otro componente. La utilidad potencial está en hacer explícitas etapas que un realizador ya reconoce: preproducción, continuidad, montaje y control de calidad.
Co-Director convierte una idea en decisiones cinematográficas
Co-Director propone un flujo de narración donde agentes colaboran para ampliar una idea, estructurar escenas y transformar el plan en tomas. El sistema utiliza modelos de lenguaje y generación visual para conservar una dirección global mientras produce segmentos manejables.
Google informa una puntuación de preferencia de 81,4 para Co-Director en su evaluación. El número debe leerse dentro del protocolo del trabajo, no como un porcentaje universal de videos “correctos”. La prueba refleja comparaciones y criterios definidos por los autores; esta redacción no reprodujo el benchmark ni verificó el desempeño con proyectos externos.
La contribución importante es metodológica. Un plan intermedio permite revisar la secuencia antes de gastar recursos generando cada toma. Para un equipo creativo, eso podría facilitar detectar una transición imposible o un personaje ausente en la etapa de storyboard. Sin embargo, el artículo no demuestra que el sistema sustituya la dirección humana ni que pueda resolver derechos de autor, consentimiento o precisión factual.
CANVAS usa un storyboard como memoria de continuidad
CANVAS, sigla de *Continuity-Aware Narratives via Visual Agentic Storyboarding*, pone el foco en el storyboard. El sistema crea representaciones visuales y descripciones que funcionan como referencias compartidas para las escenas siguientes. La intención es evitar que cada plano se genere como si empezara desde cero.
Según los experimentos de los autores, CANVAS mejoró 21,6% la consistencia de fondo, 9,6% la de personajes y 7,6% la de objetos frente a las bases usadas en su comparación. Son mejoras relativas dentro de un conjunto experimental propio. No indican que el sistema alcance continuidad perfecta ni que esas cifras se trasladen a cualquier estilo, duración o idioma.
El diseño apunta a un problema práctico: la continuidad no depende solamente del rostro principal. También importa si la mesa, la iluminación, la posición de una mochila o la hora del día coinciden de una toma a otra. Al mantener referencias estructuradas, los agentes pueden condicionar nuevas generaciones y comprobarlas contra el plan.
A²RD y VQQA agregan memoria y revisión
A²RD, un enfoque de difusión autorregresiva con agentes, intenta extender una secuencia sin dejar que las decisiones anteriores se diluyan. El trabajo combina planificación y memoria para seleccionar el contexto relevante antes de generar el próximo tramo. Google atribuye al método mejoras de hasta 30% en consistencia y 20% en coherencia en sus evaluaciones.
La expresión “hasta” es esencial: identifica el mejor aumento observado en ciertas condiciones, no un rendimiento garantizado. Tampoco significa que un video sea 30% mejor para todas las audiencias. Consistencia visual y coherencia narrativa son dimensiones evaluadas con métricas y preferencias, pero una pieza puede mejorar en ellas y seguir fallando en ritmo, intención o veracidad.
El cuarto proyecto, VQQA, se concentra en evaluación y mejora de calidad. Sus agentes formulan preguntas sobre el video, buscan evidencia en los fotogramas y generan observaciones para corregir el resultado. Los autores reportan aumentos de 11,57 y 8,43 puntos en dos métricas incluidas en el estudio. Como en los demás casos, son resultados del equipo investigador y no una auditoría independiente.
Esta capa de revisión puede ser tan relevante como la generación. Un sistema que produce más minutos sin una forma de localizar fallas también multiplica el costo de inspección. La evaluación automática podría priorizar segmentos problemáticos, pero no debería ser el único control: un evaluador construido con modelos relacionados puede pasar por alto errores similares a los del generador.
Qué cambia para creadores y equipos de comunicación
Los cuatro trabajos sugieren un flujo de producción más modular. Antes de generar, definí personajes, lugares, objetos y hechos que no deben cambiar. Separá una historia en escenas y planos. Después de cada bloque, compará el resultado con esas referencias y regenerá solamente lo que falla. Esa lógica puede aplicarse incluso sin acceso a los prototipos de Google.
Para una agencia, productora o equipo educativo de Paraguay y América Latina, la promesa más útil no es hacer una película completa con un clic. Es reducir iteraciones ciegas y conservar una bitácora de decisiones. Un storyboard aprobable, una ficha por personaje y una lista de controles permiten que una persona detecte errores antes de publicar.
También hay límites concretos. Una secuencia visual coherente puede inventar uniformes, edificios, procedimientos o acontecimientos. Si el video representa una institución, un producto o un hecho real, verificá cada elemento. Conservá permisos para imágenes, voces y música; señalá el carácter sintético cuando pueda confundirse con un registro documental; y mantené una revisión humana sobre el montaje final.
Los trabajos mencionan Gemini y Veo como piezas de investigación, pero no establecen que estos sistemas estén disponibles como una función integrada en la aplicación Gemini, Google Cloud o una API. Google no publicó plan, precio, países habilitados ni fecha de lanzamiento comercial para Co-Director, CANVAS, A²RD o VQQA.
Qué conviene observar ahora
El siguiente paso será comprobar si los métodos funcionan fuera de las demostraciones y conjuntos de evaluación de sus autores. Harán falta comparaciones independientes, proyectos con historias más largas, diferentes estilos visuales y pruebas que midan cuánto trabajo humano se ahorra realmente después de contar revisiones y regeneraciones.
También importa la transparencia. Un flujo multiagente debería permitir rastrear qué agente creó el guion, qué referencia usó, qué clip reemplazó y por qué lo aprobó. Esa trazabilidad ayuda a corregir errores y a determinar responsabilidades; no convierte automáticamente el contenido en seguro o verdadero.
La publicación de Google marca una dirección de investigación: pasar del clip aislado a sistemas que planifican, recuerdan y revisan. Todavía queda distancia entre mejores métricas experimentales y una herramienta confiable para producir videos largos. Para los equipos creativos, la lección inmediata es más sobria: tratá la generación como una cadena de producción verificable, no como una única caja de texto.
Fuentes
- Google Research: Automating coherent long-form video generation, 24 de septiembre de 2026.
- Co-Director: Agentic Generative Video Storytelling, prepublicación de abril de 2026.
- CANVAS: Continuity-Aware Narratives via Visual Agentic Storyboarding, prepublicación de abril de 2026.
- A²RD: Agentic Autoregressive Diffusion for Long Video Consistency, prepublicación de mayo de 2026.
- VQQA: An Agentic Approach for Video Evaluation and Quality Improvement, prepublicación de marzo de 2026.