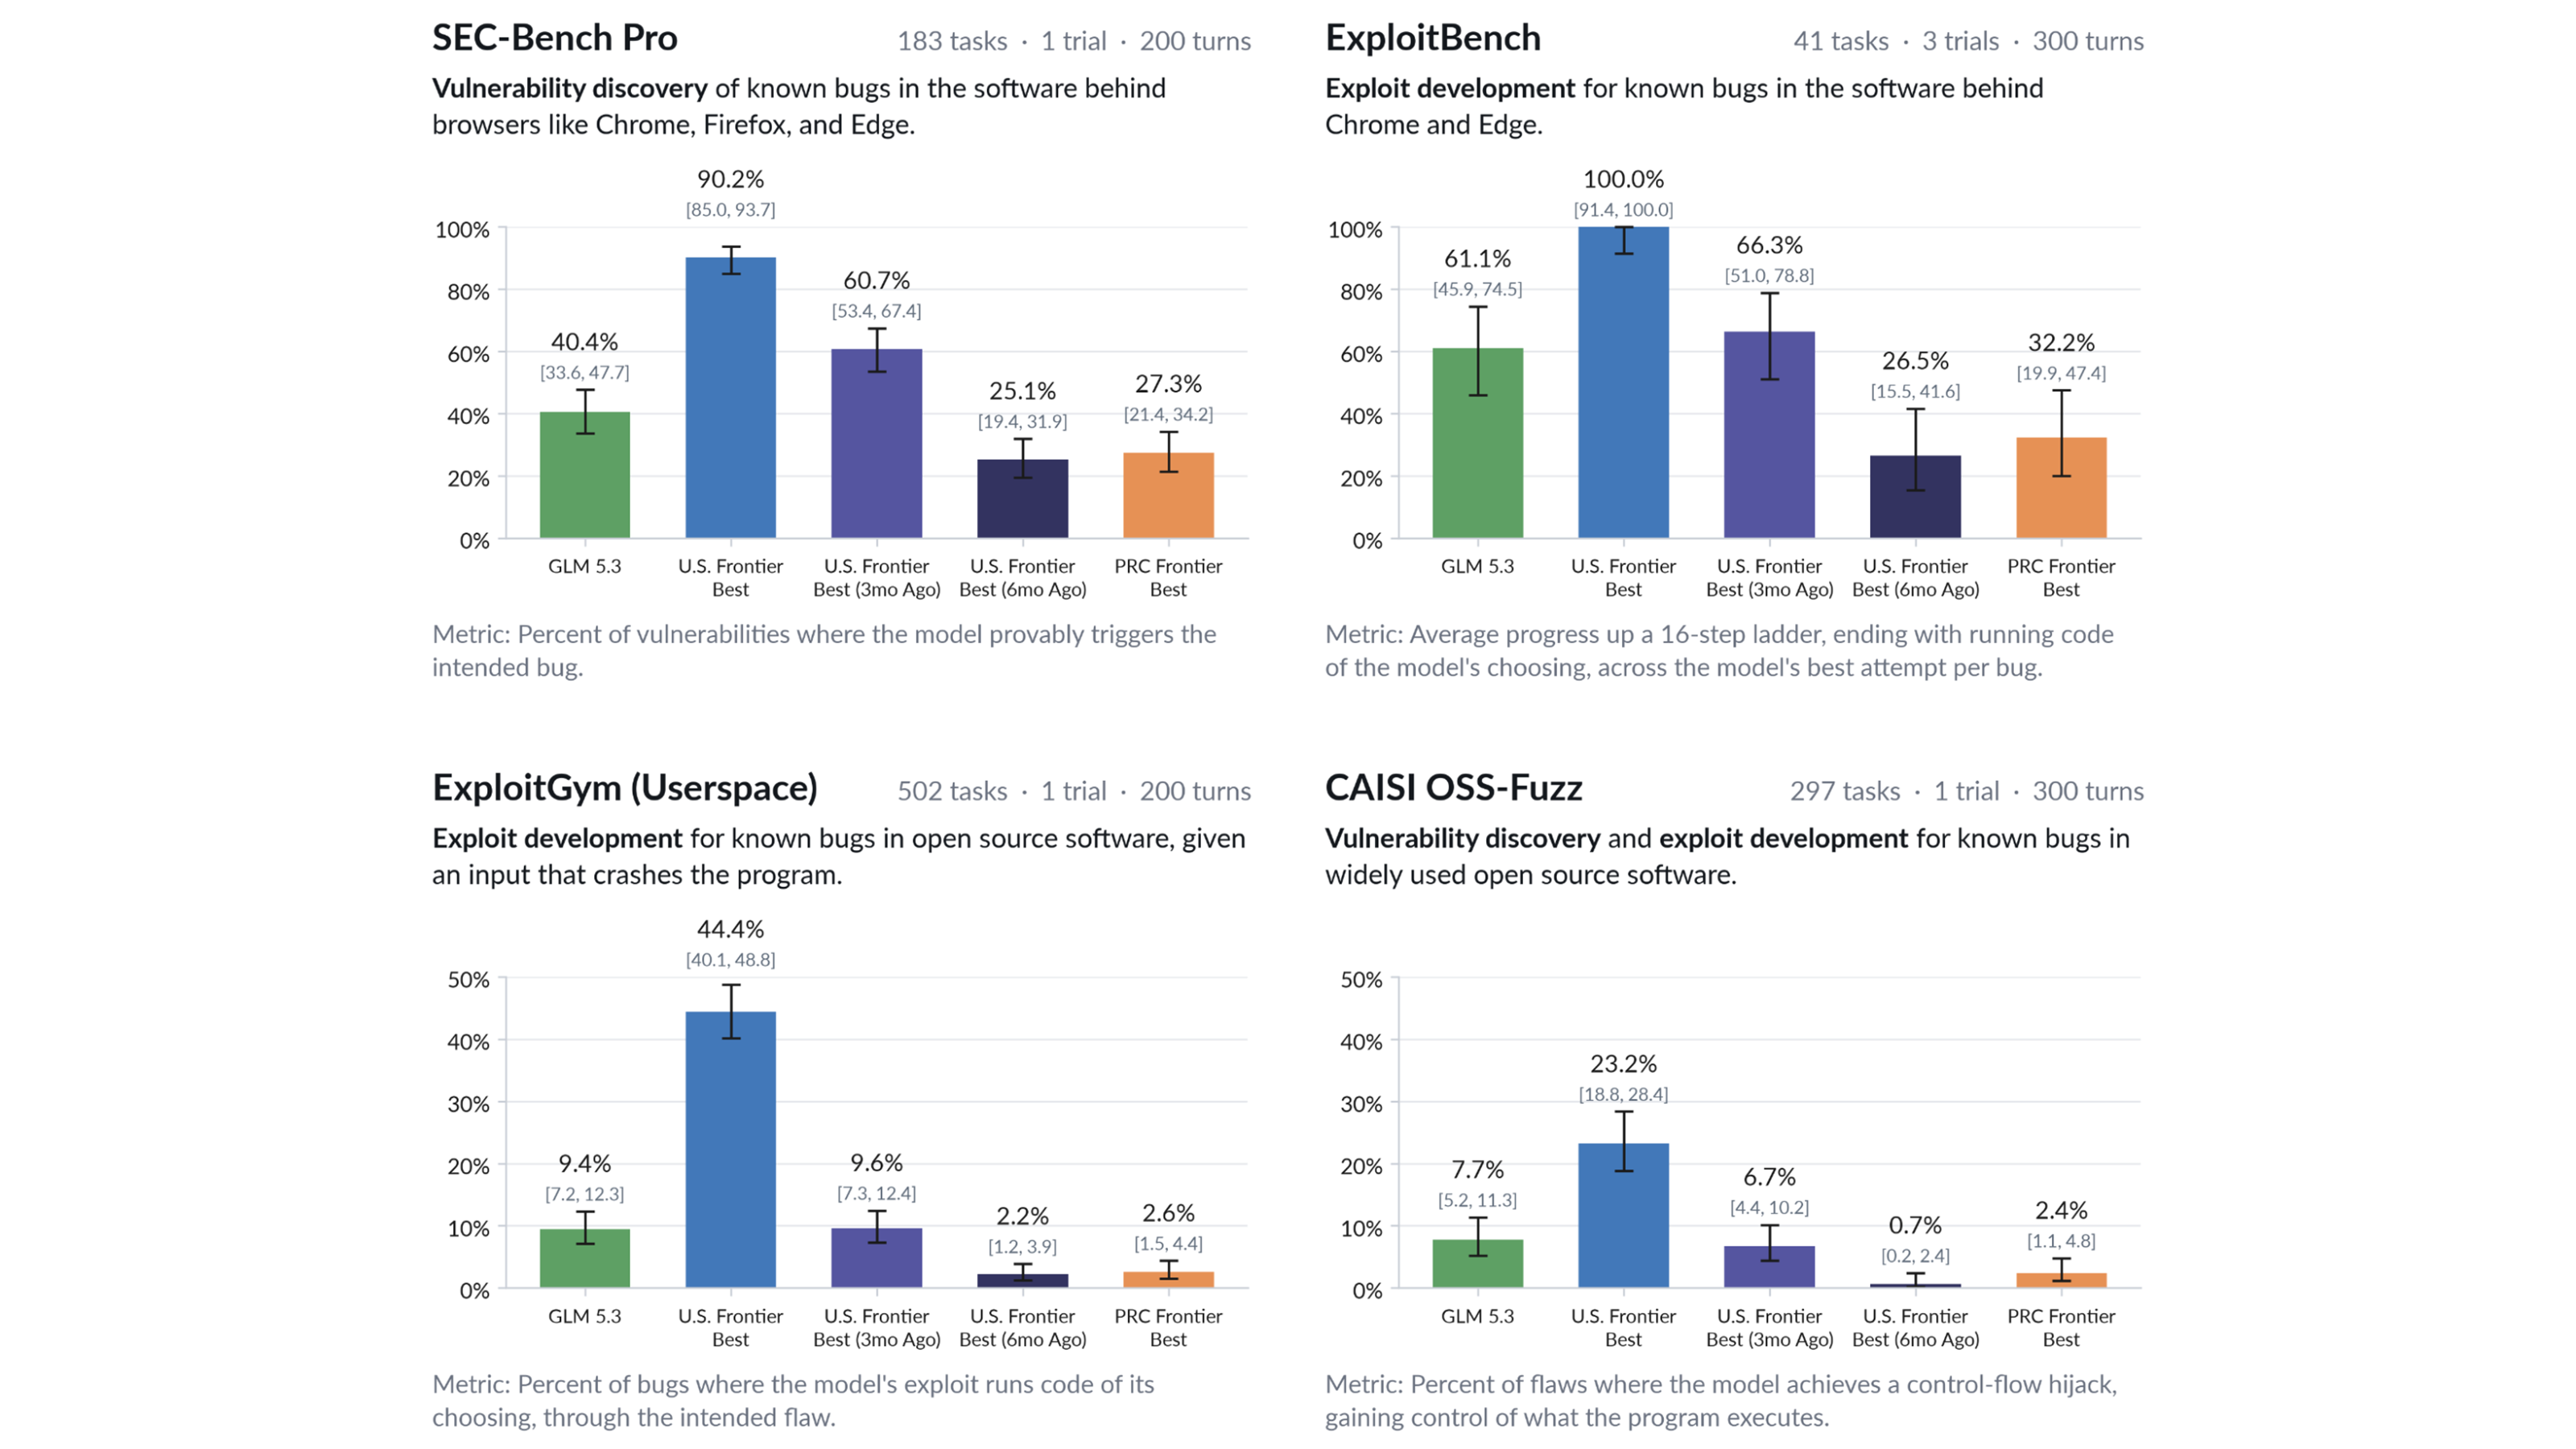
El modelo abierto de Z.ai fue el más capaz entre los sistemas de pesos abiertos probados por CAISI, pero quedó detrás de modelos estadounidenses de frontera. Los resultados pertenecen a cuatro pruebas controladas y no demuestran desempeño en ataques reales.
Qué evaluó el NIST
El Centro de Estándares e Innovación de Inteligencia Artificial de Estados Unidos (CAISI), alojado en el NIST, publicó el 17 de septiembre de 2026 una evaluación de las capacidades cibernéticas de GLM-5.3, un modelo de la empresa china Z.ai. El análisis lo ubica como el modelo de pesos abiertos más capaz entre los que CAISI había evaluado, no como el mejor sistema abierto disponible para cualquier tarea ni como líder absoluto de ciberseguridad.
La precisión importa porque una frase más amplia cambiaría el hallazgo. CAISI comparó modelos bajo un conjunto concreto de pruebas y configuraciones. Dentro de ese marco, GLM-5.3 superó a otros modelos de pesos abiertos examinados por el centro, pero permaneció detrás de los modelos estadounidenses de frontera usados como referencia.
Z.ai presentó GLM-5.3 el 14 de agosto y publicó sus pesos aproximadamente dos semanas después. La ficha del modelo en Hugging Face permite acceder a los archivos y a información técnica; su uso está regido por una licencia específica, que conviene leer antes de incorporarlo a un producto. Tener pesos descargables facilita inspección y despliegue propio, pero no elimina requisitos de infraestructura, seguridad, gobernanza o cumplimiento.
Cuatro pruebas, cuatro resultados distintos
CAISI usó cuatro bancos de pruebas. Los porcentajes no son intercambiables porque cada uno mide tareas, escalas y criterios de éxito diferentes. Sumarlos o promediarlos produciría una cifra sin significado técnico.
En SEC-Bench Pro, orientado a desafíos de seguridad en código, GLM-5.3 resolvió 74 de 183 tareas, equivalente a 40,4%. Es el resultado más alto del modelo entre los cuatro conjuntos, pero también implica que no completó la mayoría de los casos.
En ExploitBench, el informe registra 61,1%, expresado como un promedio de 9,8 tareas resueltas sobre 16 bajo una configuración *best-of-three*. Ese método permite hasta tres intentos y toma el mejor resultado, por lo que no debe leerse como la probabilidad de éxito de una primera respuesta. Sirve para estimar capacidad disponible cuando existe margen para repetir, no fiabilidad de una ejecución única.
En ExploitGym, GLM-5.3 completó 47 de 498 desafíos, o 9,4%. En la evaluación de OSS-Fuzz realizada por CAISI resolvió 23 de 297, equivalente a 7,7%. Estas tasas mucho menores muestran por qué no conviene resumir la capacidad cibernética de un modelo con el mejor número del reporte.
Los cuatro resultados describen rendimiento en entornos diseñados para evaluación. No prueban que GLM-5.3 haya atacado sistemas reales, descubierto vulnerabilidades inéditas en producción ni ejecutado una campaña autónoma. Tampoco miden por sí solos defensa integral, calidad de un análisis de riesgo o seguridad de un despliegue empresarial.
Qué significa la brecha estimada de cuatro meses
El NIST estima que, al agregar el rendimiento de estas pruebas, GLM-5.3 se encuentra aproximadamente cuatro meses por detrás de modelos estadounidenses de frontera. Esa formulación es una comparación temporal basada en cuándo los sistemas de referencia alcanzaron niveles similares dentro del conjunto evaluado.
No significa que toda la industria china esté cuatro meses detrás de la estadounidense, que cada capacidad del modelo tenga esa distancia ni que la brecha vaya a mantenerse. Mucho menos permite convertir meses en una predicción lineal: modelos, herramientas, técnicas de inferencia y bancos de pruebas cambian a ritmos diferentes.
La estimación tampoco borra una señal relevante. Un modelo con pesos disponibles públicamente alcanzó resultados que CAISI considera cercanos, en términos agregados, a los de sistemas cerrados de frontera de meses anteriores. Para investigadores y responsables de seguridad, eso reduce el tiempo durante el cual ciertas capacidades permanecen limitadas a proveedores con acceso controlado.
Al mismo tiempo, “pesos abiertos” no equivale automáticamente a transparencia completa. Se puede inspeccionar y ejecutar el modelo, pero una auditoría seria también necesita documentación sobre datos, entrenamiento, ajustes, evaluaciones y límites. La licencia define usos permitidos; la disponibilidad técnica no garantiza que cualquier organización pueda operar el sistema de forma segura o económica.
Qué cambia para equipos de ciberseguridad
La utilidad inmediata del reporte no es decidir si GLM-5.3 “es peligroso”, sino mejorar cómo se evalúan modelos antes de conectarlos con herramientas. Si tu equipo considera usarlo para revisar código, reproducir fallas o asistir pruebas autorizadas, probalo con tareas representativas de tu entorno y separá capacidad de confiabilidad.
Una evaluación interna debería registrar al menos éxito en el primer intento, mejora con reintentos, falsos positivos, comandos propuestos, necesidad de supervisión y tiempo total de verificación. Aplicá el modelo únicamente en entornos aislados y con autorización explícita. No le entregues credenciales de producción ni acceso de red más amplio del necesario para la prueba.
También conviene distinguir asistencia de autonomía. Que un sistema resuelva parte de un banco de explotación no demuestra que pueda planificar una operación completa de manera fiable. Pero tampoco hace falta autonomía total para aumentar la productividad de una persona experta. Un modelo puede acelerar búsqueda, escritura de código o análisis de errores, mientras un operador humano decide objetivos y valida cada paso.
Para organizaciones de Paraguay y América Latina, el atractivo de los pesos abiertos puede estar en mayor control sobre dónde se procesan datos y en la posibilidad de desplegar localmente. Esa ventaja potencial depende de contar con hardware, personal y controles adecuados. Antes de adoptar, revisá la licencia, el origen de los archivos, los costos de infraestructura, la trazabilidad de las acciones y la política para reportar vulnerabilidades.
Qué no demuestra el informe
Los resultados no son evidencia de ataques en el mundo real. Un banco de pruebas ofrece tareas delimitadas, señales de éxito y condiciones reproducibles; una red operativa agrega autenticación, defensas, datos incompletos, consecuencias legales y adversarios que reaccionan. La distancia entre ambos contextos puede ser grande.
Tampoco existe un único porcentaje capaz de ordenar todos los modelos. Cambiar las herramientas permitidas, el número de intentos, el tiempo disponible o la forma de puntuar puede alterar la clasificación. La comparación “más capaz” debe permanecer atada al conjunto de modelos efectivamente evaluados por CAISI.
Finalmente, el reporte mide una fotografía. GLM-5.3 fue lanzado el 14 de agosto y sus pesos llegaron después; nuevas versiones, ajustes comunitarios o técnicas de uso podrían cambiar el rendimiento. Del mismo modo, los modelos cerrados de referencia pueden avanzar. La estimación de cuatro meses describe esta evaluación, no una ley permanente.
Qué conviene observar ahora
El siguiente paso útil será comprobar si CAISI publica resultados reproducibles, configuraciones completas y evaluaciones comparables de más modelos. También importará saber cómo se comporta GLM-5.3 en defensa: priorización de vulnerabilidades, corrección de código, explicación de riesgos y rechazo de instrucciones no autorizadas.
Si administrás seguridad, tomá el informe como una señal para actualizar tus pruebas, no como un veredicto universal. Los números muestran capacidad parcial y desigual en cuatro escenarios controlados. La conclusión más sólida es acotada: GLM-5.3 lideró a los modelos de pesos abiertos que CAISI había examinado, se acercó a referencias de frontera anteriores y todavía dejó sin resolver una parte considerable de los desafíos.
Fuentes
- NIST/CAISI: evaluación de las capacidades cibernéticas de GLM-5.3, publicada el 17 de septiembre de 2026.
- Z.ai: ficha oficial de GLM-5.3 en Hugging Face.
- Z.ai: licencia de GLM-5.3.
- Axios: anuncio de GLM-5.3, publicado el 14 de agosto de 2026.