<!-- Opciones de titular: 1. ServiceNow convierte fallas de agentes en datos de entrenamiento y reporta mejoras en dos pruebas empresariales [ELEGIDO] 2. AutoSynthData usa los errores de agentes para construir un currículo de entrenamiento verificable 3. ServiceNow reporta hasta 8,41 puntos de mejora con datos sintéticos dirigidos a fallas de agentes -->
# ServiceNow convierte fallas de agentes en datos de entrenamiento y reporta mejoras en dos pruebas empresariales
AutoSynthData genera tareas ejecutables a partir de debilidades observadas. Los resultados son prometedores, pero provienen de una evaluación de la propia empresa en EnterpriseOps Gym.
Qué presentó ServiceNow
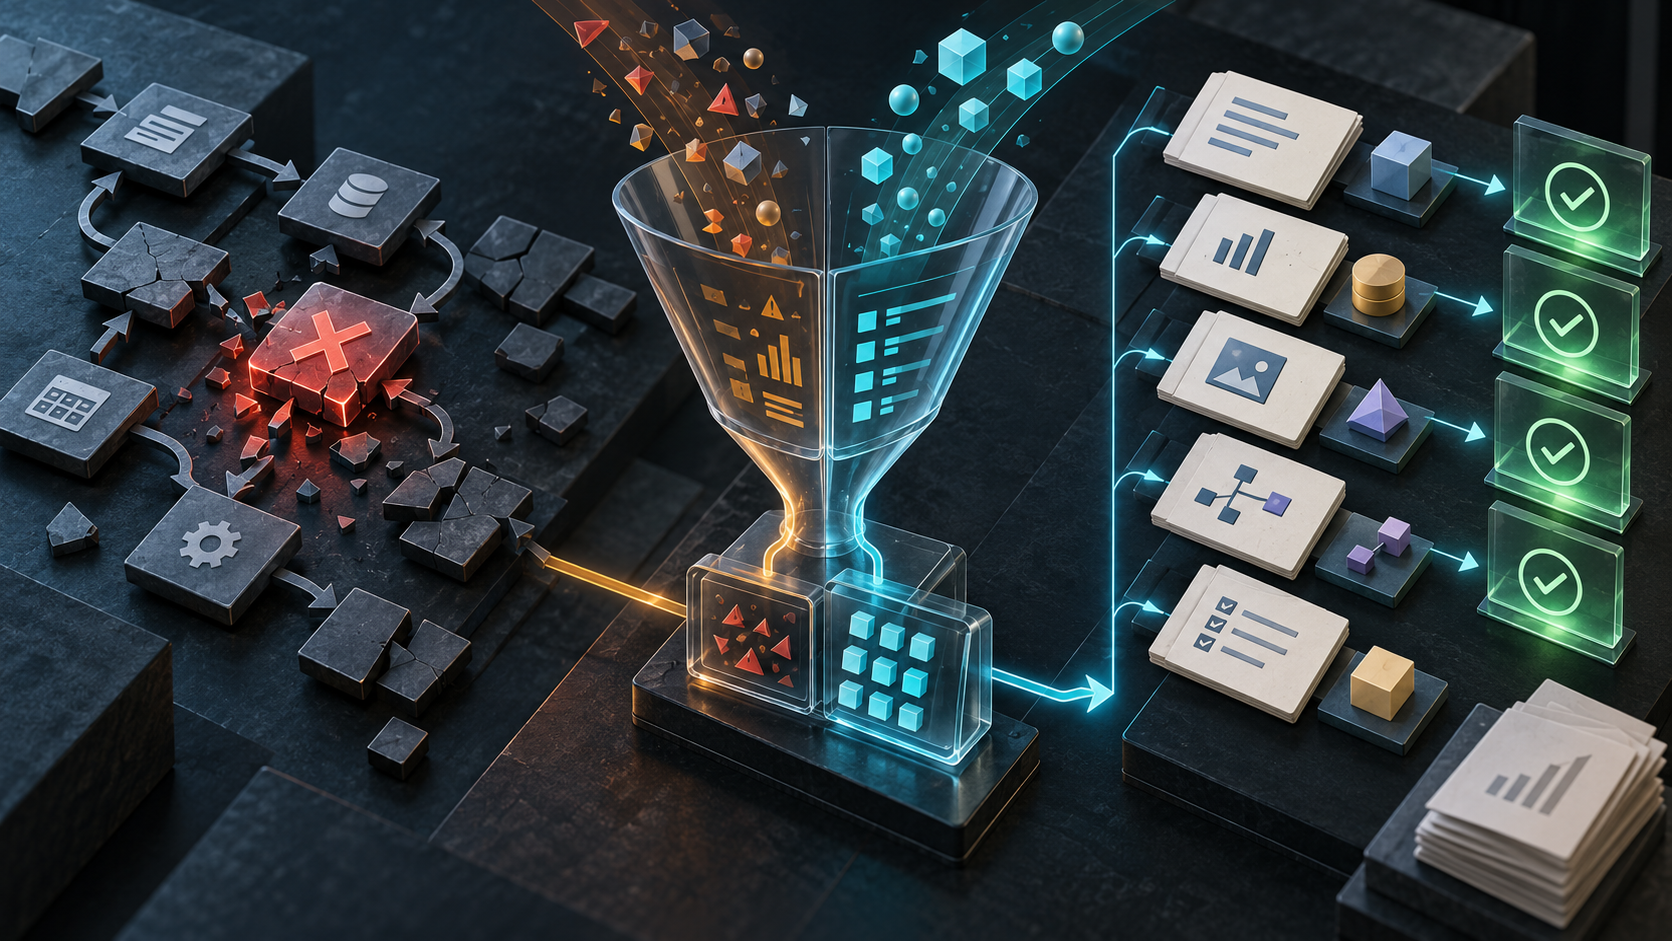
ServiceNow CoreAI presentó el 2 de octubre AutoSynthData, un método para crear datos sintéticos de entrenamiento dirigidos a las fallas concretas de un agente de inteligencia artificial. La idea no es producir miles de instrucciones genéricas, sino observar dónde tropieza un modelo dentro de un entorno empresarial, describir la capacidad que le falta y generar tareas nuevas que ejerciten precisamente esa debilidad.
Según el artículo técnico publicado por ServiceNow en Hugging Face, el sistema produjo 2.000 muestras para el dominio Hybrid de EnterpriseOps Gym en unas 18 horas. Después del ajuste supervisado, la empresa reportó una mejora de 7,2 puntos porcentuales en Pass@1. En otro ensayo, dentro del dominio ITSM, generó 1.994 muestras en 66 horas y elevó Pass@1 de 18,77% a 27,18%.
Esos números ayudan a dimensionar el potencial, pero requieren una cautela esencial: son resultados informados por el equipo que desarrolló el método, en un único banco de pruebas —EnterpriseOps Gym— y sin una validación independiente publicada. Tampoco equivalen a que AutoSynthData sea un producto comercial disponible para cualquier cliente de ServiceNow.
De un error aislado a un currículo
Entrenar un agente para una empresa presenta un problema distinto al de mejorar un chatbot general. El agente debe entender reglas internas, usar herramientas específicas y modificar estados reales: abrir un ticket, asignar un responsable, actualizar una base de datos o cumplir una secuencia de autorizaciones. Un modelo capaz en tareas generales puede fallar cuando combina varias herramientas o cuando el estado inicial no coincide con los ejemplos que vio durante el entrenamiento.
AutoSynthData parte de ejecuciones diagnósticas del modelo objetivo y las compara con el desempeño de un modelo “docente” más fuerte. De esa comparación extrae especificaciones de capacidad sanitizadas: qué habilidad se está midiendo, qué flujo de herramientas interviene, dónde falla el objetivo y qué condiciones debe satisfacer el estado final.
El generador no recibe los prompts originales de evaluación, sus entidades ni los verificadores. Recibe esas tarjetas de capacidad y crea tareas diferentes, con nuevos estados, solicitudes y rutas de solución. El objetivo es reducir el riesgo de memorizar el examen y producir ejemplos que mantengan la capacidad buscada.
La construcción ocurre en dos fases. En Target, trabajadores paralelos generan y validan muestras centrales. En Multiply, cada muestra aceptada sirve para crear variantes, pero una variante no puede originar otra variante. Esa restricción busca limitar la deriva que aparece cuando datos sintéticos se reciclan durante muchas generaciones.
La verificación es el centro de la propuesta
Una instrucción plausible no es necesariamente un buen dato de entrenamiento. Puede pedir algo imposible, incluir una solución que no funciona o usar un verificador que premie un estado incorrecto. Por eso, el planteamiento combina generación con ejecución real en el entorno, evaluación del solucionador, pruebas positivas y negativas, y un proceso acotado de reparación.
En la configuración descrita por ServiceNow, el sistema favorece tareas que el modelo objetivo resuelve como máximo en uno de tres intentos, mientras que el modelo más fuerte debe resolver al menos dos de tres. La intención es encontrar un punto intermedio: ejemplos que expongan una carencia real, pero que sigan siendo solucionables.
Este detalle importa para equipos que diseñan agentes. Acumular conversaciones artificiales puede aumentar el volumen sin mejorar la habilidad que falla. AutoSynthData plantea que los datos deben estar conectados con un diagnóstico, un entorno ejecutable y un criterio determinista de éxito. El valor no estaría solo en generar, sino en cerrar el ciclo entre evaluación y entrenamiento.
Qué muestran —y qué no— los resultados
Para Hybrid, ServiceNow usó Gemma-4-26B-A4B-it como modelo objetivo y Qwen3.8-27B como docente. La empresa afirma que las 2.000 muestras se generaron en aproximadamente 18 horas y que el mejor checkpoint, en la época 5, mejoró el promedio de Pass@1 en 7,2 puntos. También informó que el éxito del verificador pasó de 63,01% a 68,55%.
En ITSM, el objetivo volvió a ser Gemma-4-26B-A4B-it, mientras que el docente fue DeepSeek-V4.1-Flash. Las 1.994 muestras tardaron 66 horas en producirse. ServiceNow atribuye la diferencia de tiempo a un docente más grande y a que esa ejecución precedió optimizaciones posteriores de la tubería. Pass@1 pasó de 18,77% a 27,18%, una ganancia absoluta de 8,41 puntos porcentuales.
Las dos pruebas indican que un currículo adaptado puede mover el rendimiento dentro de ese entorno. No demuestran todavía que el método se transfiera con la misma eficacia a CRM, finanzas, salud, sistemas propietarios o procesos con verificadores ambiguos. Tampoco comparan públicamente el costo total con alternativas como datos humanos, ajuste por preferencias o una mejora directa del modelo base.
Qué cambia para equipos de IA empresarial
La propuesta ofrece una forma práctica de pensar el mantenimiento de agentes: no como un entrenamiento único, sino como un ciclo. Primero medí los fallos; después agrupá las capacidades ausentes; generá tareas nuevas; ejecutalas; descartá las defectuosas; ajustá el modelo; y volvé a evaluar.
Para que ese enfoque funcione en una empresa, hacen falta entornos de prueba aislados, estados reiniciables y verificadores confiables. También hay que proteger los datos. ServiceNow dice que usa tarjetas sanitizadas en lugar de entregar al generador las tareas originales, pero cada organización tendría que revisar qué información entra en el diagnóstico, qué proveedor procesa las muestras y si las variantes podrían reconstruir detalles sensibles.
Otro límite es la supervisión. Un verificador automático puede confirmar que un ticket terminó en el estado esperado, pero no siempre detecta una decisión innecesaria, una explicación engañosa o un riesgo operativo. En flujos críticos, conviene combinar métricas automáticas con revisión humana y pruebas adversariales.
Qué conviene observar ahora
El próximo paso relevante sería una reproducción externa que use otros modelos, ambientes y verificadores. También falta conocer si ServiceNow liberará el código completo, ofrecerá AutoSynthData como servicio o lo mantendrá como metodología de investigación.
Mientras tanto, el anuncio aporta una lección útil: el dato sintético vale más cuando responde a una falla observada y puede comprobarse mediante ejecución. Las cifras publicadas justifican seguir el método, no asumir que ya resolvió el entrenamiento de agentes empresariales.