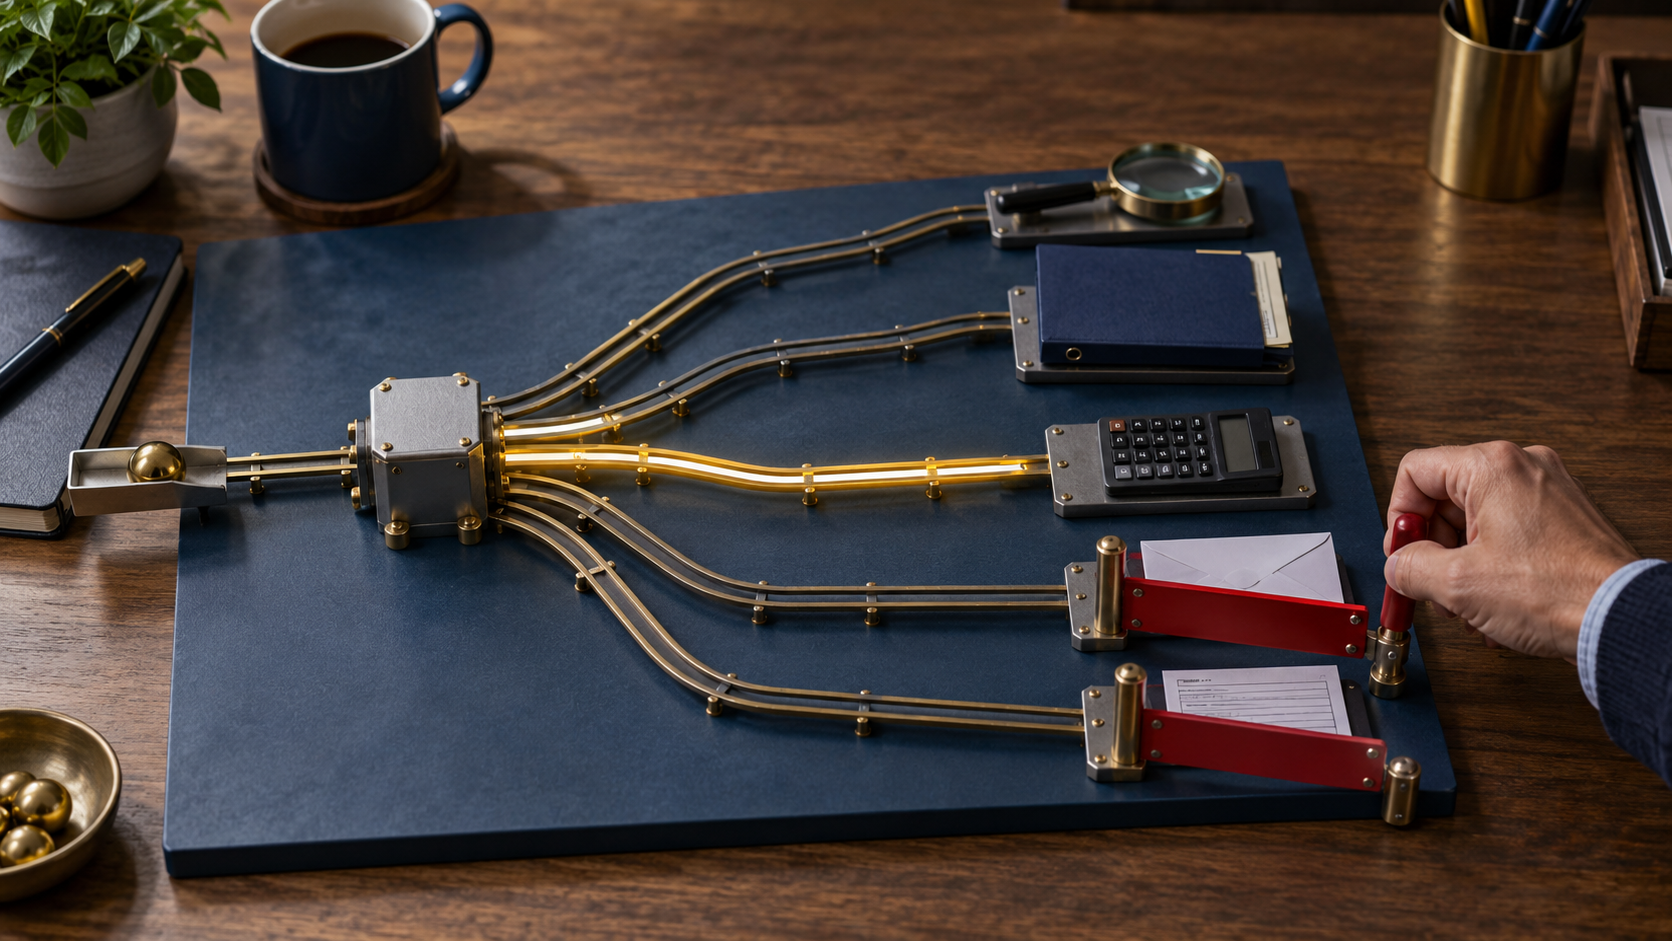
El modelo de 1.900 millones de parámetros apunta a decisiones rápidas y locales; sus cifras de rendimiento todavía son afirmaciones del equipo.
Un modelo para elegir, no para conversar
Strands Agents presentó el 1 de octubre Strands Decider 2B, un modelo abierto diseñado para una parte estrecha del trabajo de un agente: decidir qué acción o herramienta usar. A diferencia de un modelo conversacional convencional, no busca redactar una explicación extensa. Produce una decisión estructurada que otro componente del sistema puede ejecutar o pasar a un modelo generativo.
El nombre redondea el tamaño a 2B, pero el equipo informa 1.900 millones de parámetros. La arquitectura parte del torso de Qwen3.5-2B y añade una cabeza de puntero —un componente que selecciona entre opciones— ajustada con LoRA. La presentación técnica de Strands describe la idea y el repositorio público ofrece pesos, código, datos y scripts.
El lanzamiento importa porque cuestiona una práctica habitual: pedir a un gran modelo de lenguaje que razone, elija herramienta y redacte texto en cada paso. Si una decisión puede resolverse con un modelo pequeño, un agente podría reducir latencia y costo, mantener más procesamiento local y reservar modelos grandes para tareas que realmente necesitan generación.
Cómo encaja en un agente
Imaginá un asistente empresarial con cinco acciones disponibles: consultar inventario, buscar una factura, pedir aprobación, crear un borrador o responder sin herramienta. Decider recibe el estado y las opciones y selecciona una. No escribe el correo ni interpreta el documento final; orienta el siguiente paso.
Esta separación puede hacer el sistema más observable. En vez de esconder la elección dentro de una larga respuesta, el desarrollador recibe una salida discreta que puede registrar, validar y bloquear. También facilita colocar reglas antes de la ejecución: una decisión de “enviar” puede requerir confirmación humana, mientras una decisión de “buscar” puede permitirse automáticamente.
El equipo afirma que el modelo puede ejecutarse en CPU, GPU y equipos Apple. También reporta una latencia de 115 milisegundos en una RTX 3090. Esa cifra debe leerse como resultado declarado por sus creadores bajo una configuración específica, no como garantía para cualquier hardware, carga, longitud de contexto o integración.
Benchmarks abiertos, pero no conclusión definitiva
Strands publica comparaciones que favorecen a Decider en tareas de selección. La apertura de pesos, código, conjunto de datos y scripts mejora la posibilidad de auditar y repetir pruebas. Sin embargo, un benchmark no demuestra por sí solo desempeño en los flujos de una empresa.
La decisión real puede depender de nombres internos, descripciones ambiguas, permisos, contexto en español o herramientas que cambian con frecuencia. Un modelo puede obtener un buen promedio y aun fallar en la acción más riesgosa. Antes de adoptarlo, conviene construir un conjunto propio con decisiones correctas, opciones casi idénticas, datos incompletos y ataques de instrucciones incrustadas.
También importa la calibración: ¿el sistema sabe cuándo no está seguro? Si siempre selecciona una herramienta, puede convertir incertidumbre en una acción equivocada. Un diseño responsable necesita una salida de abstención, umbrales y rutas de escalamiento.
Ejecución local y arquitectura híbrida
El tamaño abre la puerta a desplegar el decisor cerca de la aplicación. Eso puede reducir llamadas externas y mejorar control sobre ciertos datos. No significa que todo el agente quede fuera de la nube: la herramienta elegida puede consultar servicios remotos y la generación final puede depender de otro modelo.
Strands muestra Amazon Bedrock como ejemplo dentro de una arquitectura híbrida, no como requisito exclusivo ni como evidencia de que el modelo esté ofrecido allí como servicio administrado. Los equipos deben distinguir entre código de integración y disponibilidad comercial.
La ventaja de separar capas también trae complejidad. Hay que versionar el catálogo de herramientas, mantener ejemplos, registrar decisiones y coordinar el decisor con políticas de seguridad. Si una función cambia de nombre o parámetros, el modelo puede necesitar nuevas pruebas o ajuste.
Qué cambia para desarrolladores y empresas
Decider 2B es relevante para agentes con muchas decisiones repetidas y bien definidas. Puede ser menos adecuado cuando la elección exige investigación abierta, razonamiento jurídico o interpretación profunda. La pregunta no es si un modelo pequeño “supera” en general a uno grande, sino qué parte del flujo puede especializarse sin perder seguridad.
Si querés evaluarlo, empezá sin permisos de ejecución. Reproducí el entorno, revisá la licencia y el origen de los datos, y corré decisiones en modo sombra junto al sistema actual. Medí exactitud por herramienta, abstenciones, falsos positivos de acciones sensibles, latencia en tu hardware y desempeño en español.
Después agregá barreras: lista permitida de herramientas, validación de argumentos, límites de tasa y aprobación humana antes de acciones externas. El modelo debe recomendar una transición de estado; la aplicación sigue siendo responsable de autorizarla.
Relevancia para Paraguay y América Latina
Un modelo pequeño y abierto puede resultar atractivo para organizaciones con presupuesto limitado o requisitos de control local. Aun así, ejecutar localmente no equivale a costo cero: hace falta hardware, mantenimiento, observabilidad y personal capaz de revisar el sistema.
Tampoco hay evidencia publicada en las fuentes revisadas sobre desempeño específico en español paraguayo o guaraní. Para un uso regional, hay que crear ejemplos representativos y comprobar que los nombres de herramientas y reglas internas se entiendan correctamente.
Qué conviene observar ahora
La apertura permitirá ver si terceros reproducen los benchmarks y encuentran fallas. También será decisivo comprobar cómo escala con catálogos grandes, herramientas similares y contextos adversariales.
Decider 2B no reemplaza al modelo que redacta ni a las reglas de negocio. Su propuesta es más concreta: convertir la selección de la próxima acción en un componente pequeño, rápido y auditable. La utilidad se demostrará cuando equipos independientes midan esa promesa en agentes reales.
Fuentes
- Strands Agents: presentación de Strands Decider, 1 de octubre de 2026.
- GitHub: strands-labs/strands-decider.
- TechCrunch: cobertura del lanzamiento, 1 de octubre de 2026.